MyContext 个人上下文管理系统
- AI PRODUCT
- CONTEXT ENGINEERING
- OBSIDIAN
- CLI / SKILL
为 Agent 管理可切换的个人上下文:把本地文件、URL 和飞书资料萃取成实体与关系,并写入独立 Obsidian Vault。
我平时会把项目资料、研究文章、临时笔记和截图散落在本地文件、网页和飞书里。自己回看时可以靠目录和搜索找到内容;Agent 接手新任务时,却通常还要重新读取资料,再判断哪些信息和当前任务有关。
MyContext 在原始资料和 Agent 之间增加了一层独立 Context:保留来源,提取稳定的实体、关系与摘要,让每个项目只把真正需要的“我”交给 Agent。
01
产品范围|先把原始资料和 Agent Context 分开
第一版设计时,我先处理一个具体问题:Agent 开始工作时,怎么拿到已经整理过的个人背景,而不是每次从原始资料重新找。
原始文档里会同时存在过程记录、最终决策、研究材料和已经过期的信息。MyContext 负责把后面可能继续使用的信息提炼出来,并保留 Source;Agent 开始任务时,优先读取已经整理过的 Context,需要确认细节时再回到原始资料。
当前系统主要处理三件事:
- 把本地文件、URL 和飞书资料接进同一套萃取逻辑
- 把文档整理成实体、关系和可检索内容
- 控制内容进入哪一个 Context,以及 Agent 后续读取哪一个库
02
资料入口|不同来源走同一套处理逻辑
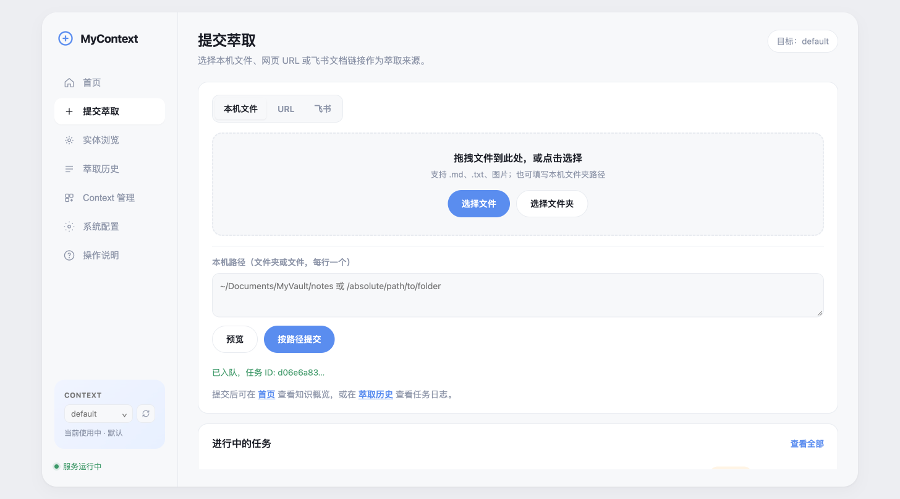
资料不一定已经整理在一个本地知识库里。提交之前先选择目标 Context;来源只影响最前面的读取方式,内容被读入以后,会进入同一套 Admission、实体关系抽取和写入逻辑。
- LOCAL
- URL
- FEISHU
03
Admission|先判断一份资料值不值得深度萃取
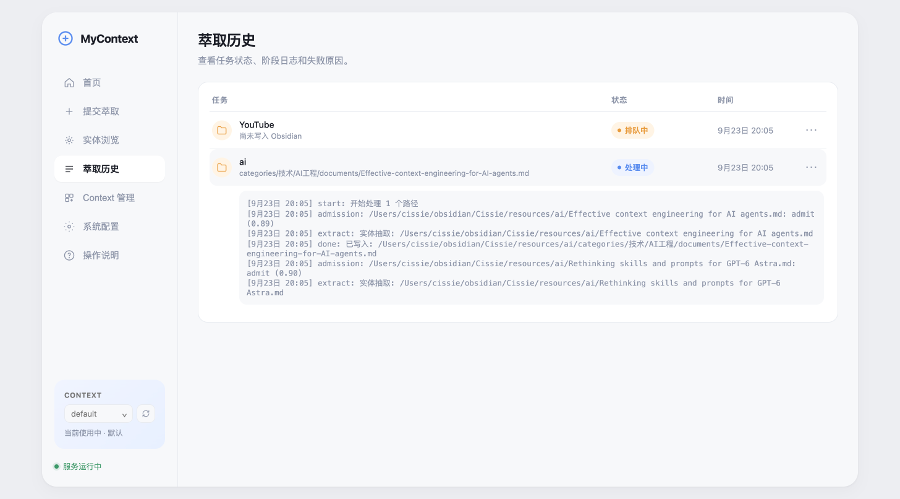
批量导入资料以后,我没有让每一份文件都直接进入完整的 LLM 萃取。长度、结构、元数据、内容密度和内容 Hash 先做便宜判断,再把任务分成三种状态。
| Status | 处理方式 |
|---|---|
| Admit | 进入完整实体、关系和摘要抽取 |
| Borderline | 保留基础内容,减少深度处理 |
| Drop | 不继续进入完整萃取 |
Hash 同时用于减少重复处理。文件没有变化时直接跳过;内容发生修改,再重新进入对应流程。
04
Entity & Relation|把文档变成可以沿关系查找的 Context
如果只给每篇资料生成一段摘要,Agent 后面仍然主要依赖文本搜索。所以我在文档层之外增加了实体和关系。
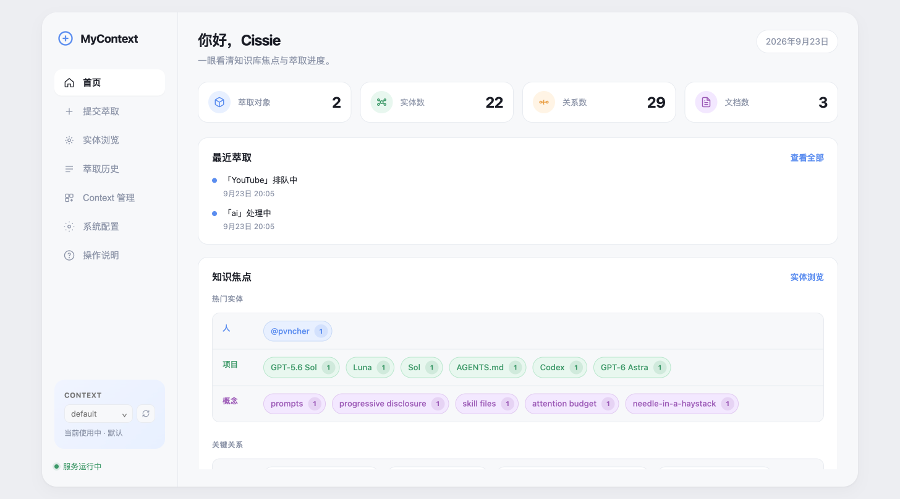
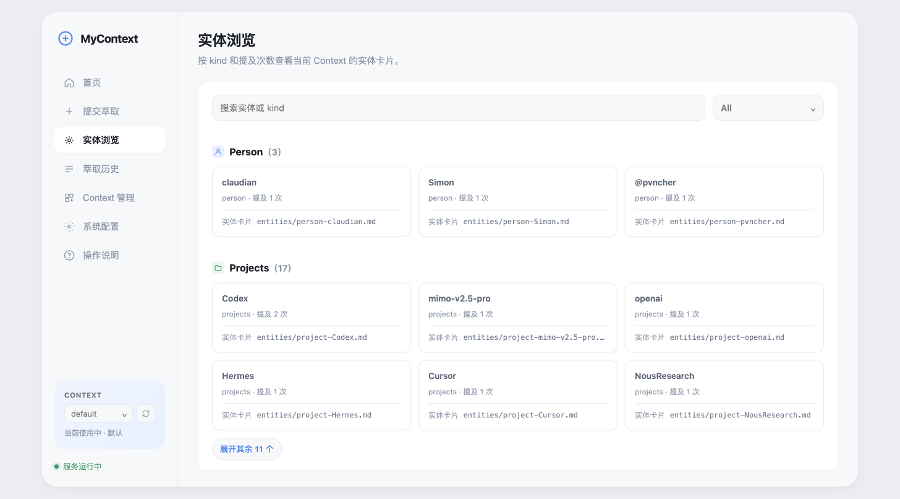
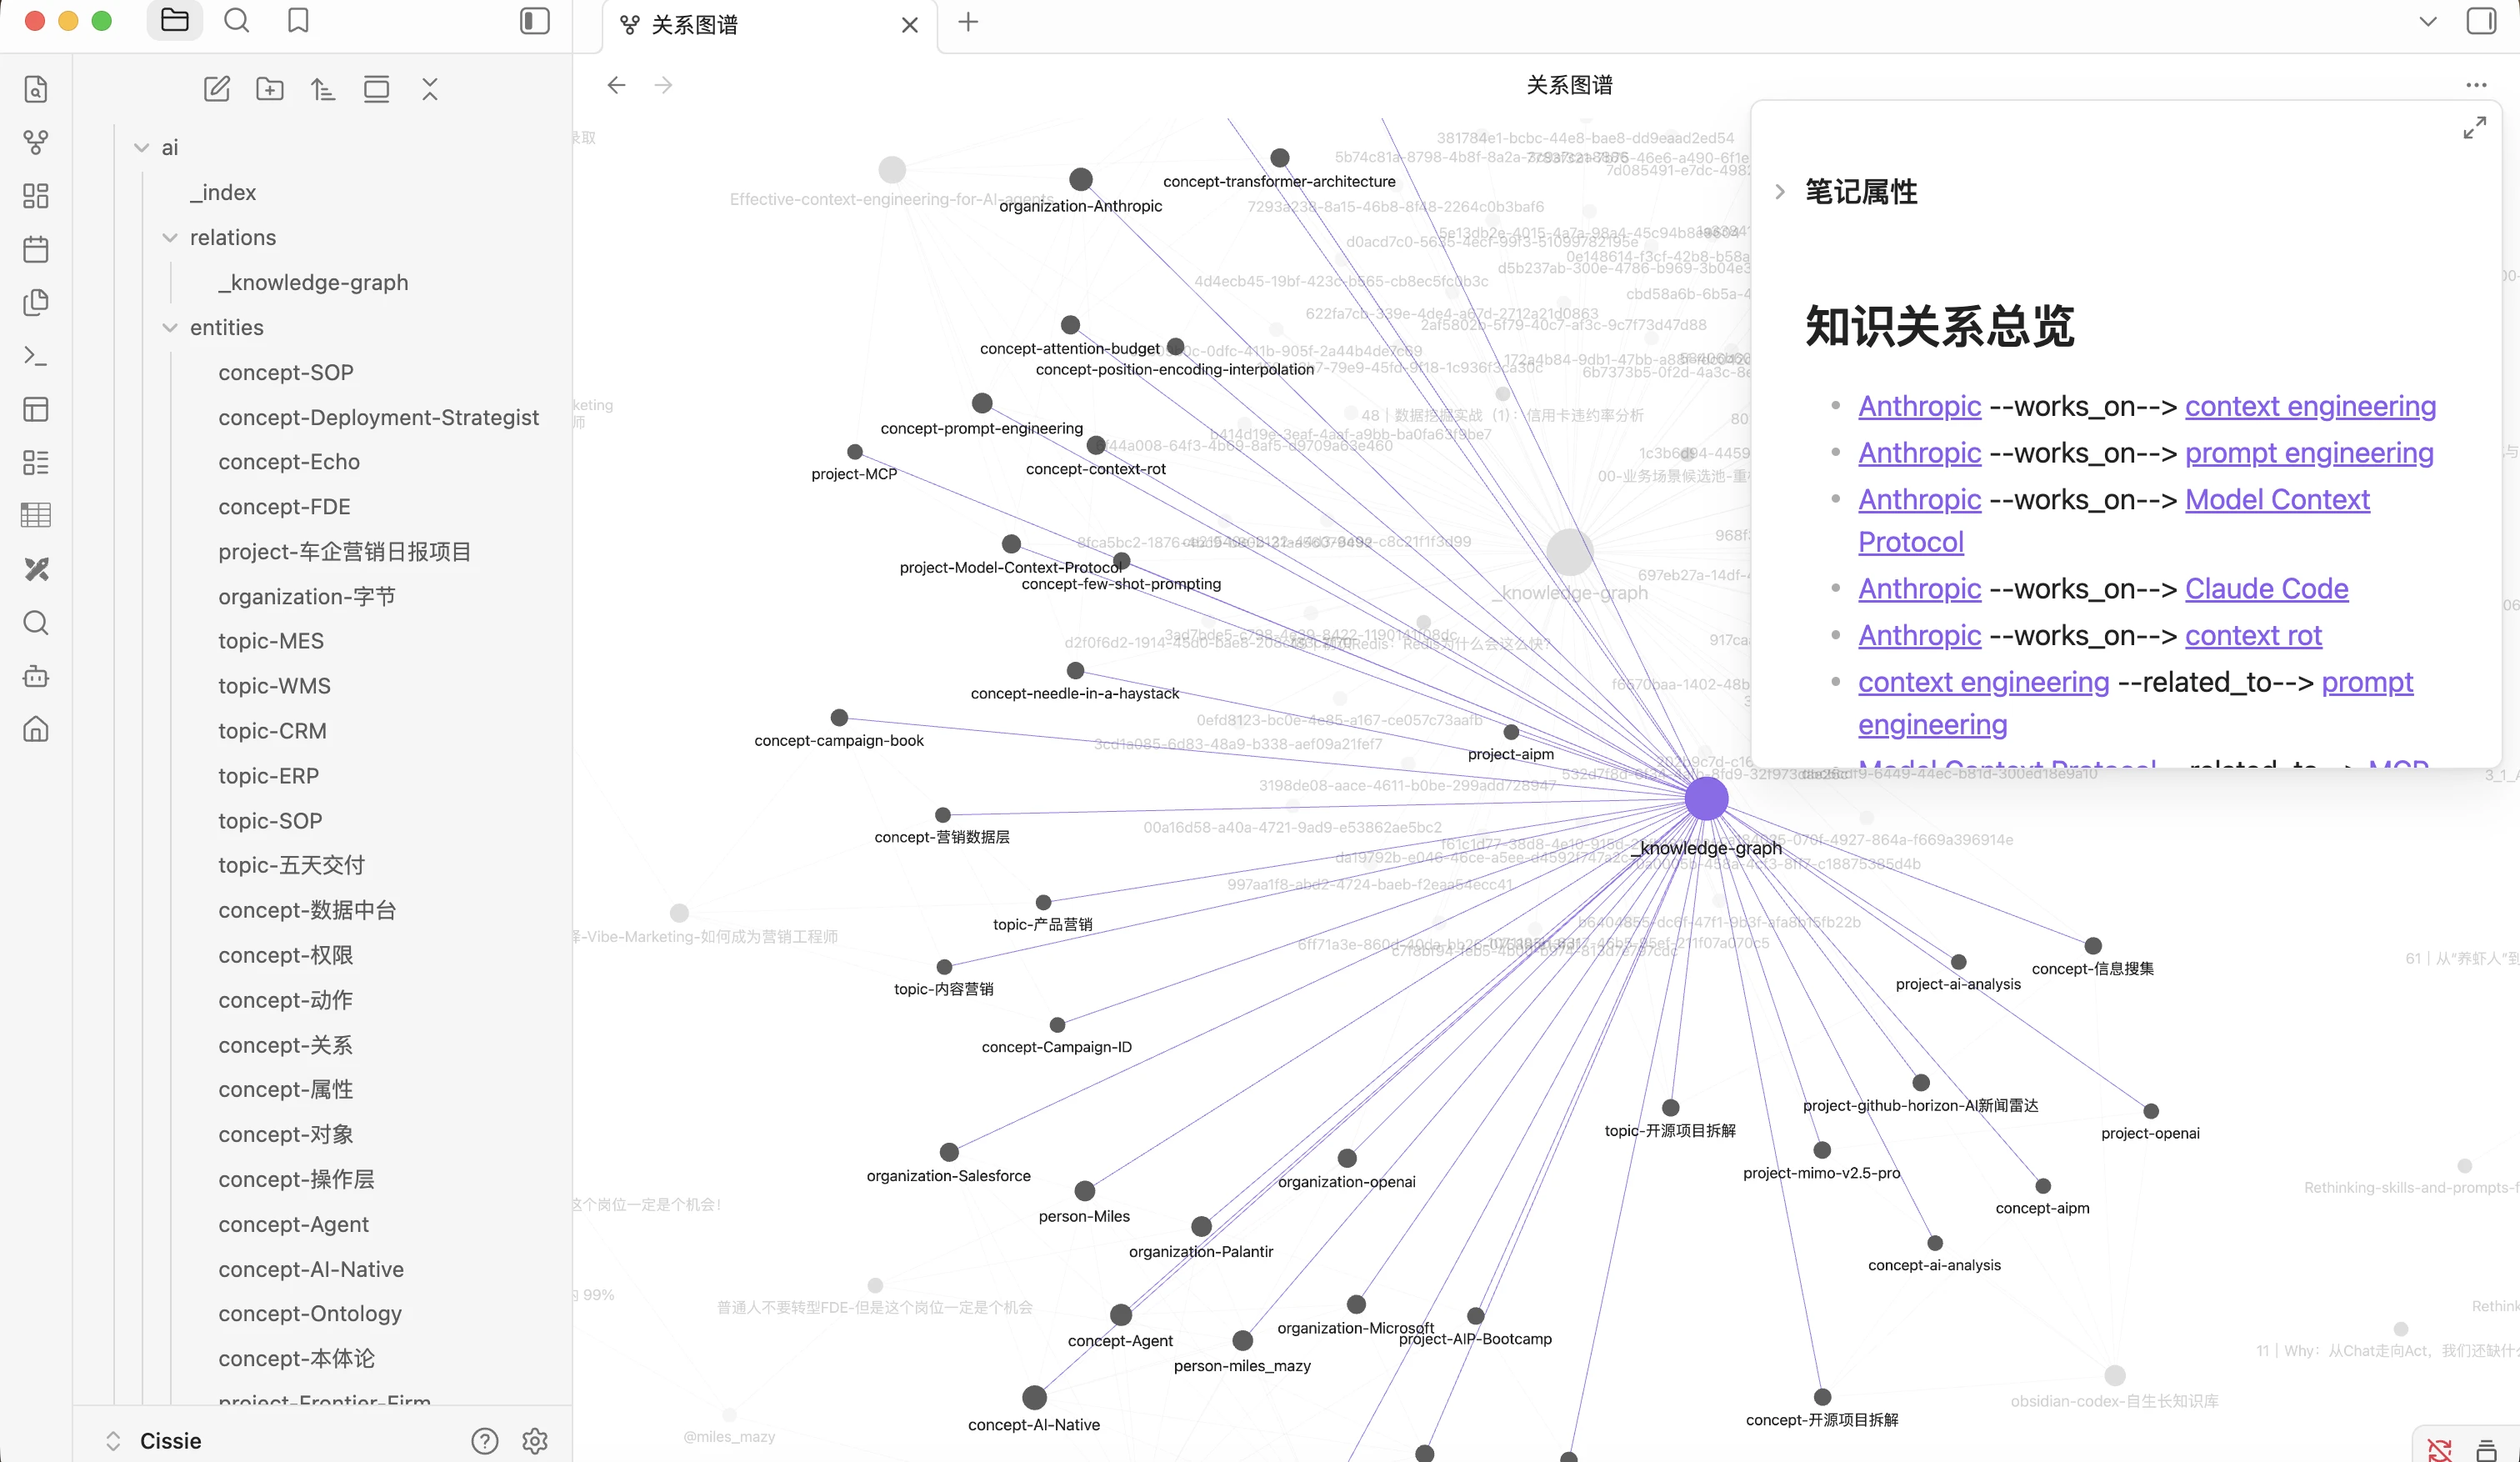
当前实际生成的实体包括 Person、Project 和 Concept。同一个实体在多份资料里再次出现时,会继续累计 mention,并通过实体卡片连接到相关文档和关系。重点不是把所有名词都抽出来,而是给后续检索提供一层稳定入口。
05
Context 管理|从 Single Vault 改成 Multi-Vault
最初的方案只有一个独立 Vault。所有项目、人物、概念和资料都会进入同一套实体关系网络,但不同任务需要 Agent 了解的“我”并不一样。
所以后面的版本把一个全局 Vault 改成多个独立 Context。每个 Context 对应一个独立 Vault,各自维护文档、实体、关系和摘要。
| Context | 更适合保存的内容 |
|---|---|
| Portfolio | Case Study、写作规则、视觉偏好、网站结构 |
| AI Product | Agent、RAG、Skill、Context Engineering、AI 项目 |
| Marketing | Campaign、Merchant、Offer、增长和业务资料 |
06
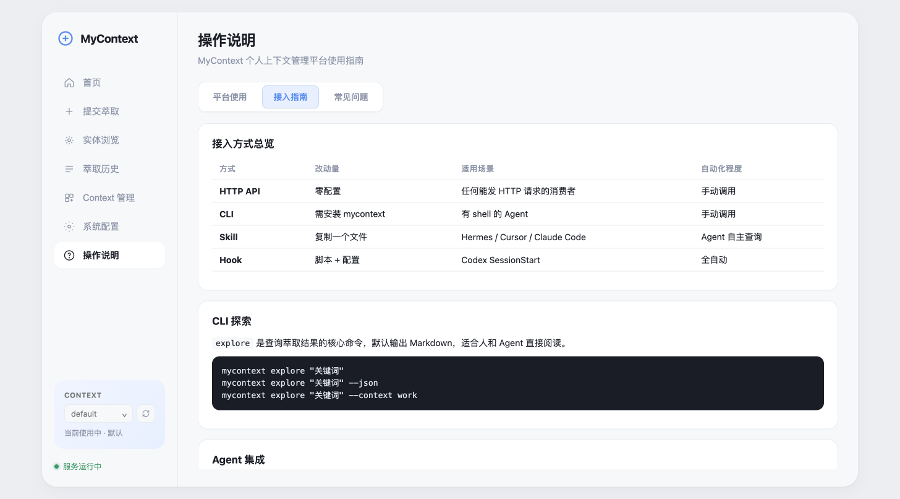
Agent 接入|CLI / Skill 只读取当前选中的库
人使用 MyContext 时,主要通过 Dashboard、实体浏览和 Obsidian 查看数据;Agent 侧使用独立的 CLI / Skill。
Agent 不需要理解具体的 Vault 目录结构,只需要知道当前使用哪个 Context、要查询什么实体或主题,以及是否需要继续打开 Source。后续增加新的 Context 时,也不需要为每个 Agent 再做一套新的记忆系统。